引言:70%之后,下一站是什么?
2026年5月,腾讯云发布的最新数据显示,云原生与Serverless架构在企业IT环境中的渗透率已超过70%。CNCF年度调查给出了更精确的数字:98%的组织已采用云原生技术,82%的容器用户在生产环境运行Kubernetes。这是一个里程碑式的节点——“要不要用云原生”已经不再是问题,“怎么用好云原生”才是真正的挑战。
但“用好”的标准正在被AI改写。
过去十年,云原生用容器、微服务和DevOps解决了“软件如何弹性地跑在云上”。而今天,AI正在提出一个更尖锐的问题:当智能本身成为系统的核心能力,云原生架构该如何为“模型+数据+算力”重新设计?
很多团队把“接入一个大模型API”就当成AI原生,结果上线后立刻撞上算力成本失控、推理延迟抖动、模型版本混乱三座大山。真正的AI原生,不是给旧架构打补丁,而是让架构原生地为智能工作负载而生。
这篇文章要回答的是:从传统架构到AI就绪云架构,应该分几步走?每一步做什么?用什么技术? 我们把它拆解为三个递进层次——容器化、Serverless化、AI原生——并提供一份可落地的实操清单。
第一章 第一层:容器化——从“物理机”到“标准化交付单元”
核心观点: 容器化是云原生架构的基石——它不是把应用“装进容器”就完事,而是建立一套从镜像构建、编排调度到声明式运维的标准化体系。这一步走不稳,后面的Serverless化和AI原生都无从谈起。
1.1 为什么容器化仍然是第一步?
2026年,Kubernetes已成为生产环境的绝对骨干。CNCF数据显示,82%的容器用户在生产环境运行Kubernetes,较2023年的66%大幅提升。66%的AI推理工作负载运行在Kubernetes上。
容器化的核心价值不是“轻量级虚拟化”,而是“标准化” 。它把应用及其依赖打包成一个可移植的单元,让应用可以在任何Kubernetes集群上以相同的方式运行、伸缩、更新和回滚。这种标准化,是后续所有自动化和智能化的前提。
1.2 2026年容器化的关键趋势
趋势一:Kubernetes向“云原生OS”演进。 2026年,Kubernetes已不再是单纯的容器编排工具,而是一个覆盖CI/CD、服务网格、可观测性、安全治理的全生命周期平台。CNCF生态图谱已包含超过150个项目。运维团队不需要从零开始,但需要系统性地建立Kubernetes知识体系。
趋势二:Wasm容器崛起。 WebAssembly(Wasm)容器正在成为轻量级、高安全性的新选择,尤其适合边缘计算和多租户场景。
趋势三:GitOps成为行业标配。 2026年,GitOps已全面普及——以Git为唯一数据溯源端口,将基础设施代码化,实现开发、部署、运维流程标准化管控。
1.3 实操清单:容器化阶段的四个关键动作
1.标准化镜像构建:建立统一的容器镜像构建流水线,确保开发、测试、生产环境一致。
2.声明式资源配置:所有Kubernetes资源(Deployment、Service、Ingress等)通过YAML/Helm声明式管理,杜绝“手动改配置”。
3.可观测性基础设施建设:容器生命周期短至分钟级甚至秒级,传统的基于IP的监控已经失效。建立Metrics、Logging、Tracing三位一体的可观测性体系。
4.FinOps成本可视化:在容器化阶段就建立资源标签体系和成本分摊机制。腾讯云TKE通过FinOps全链路管控,实现了集群整体利用率提升至65%。
第二章 第二层:Serverless化——从“管机器”到“管弹性”
核心观点: Serverless是容器化的自然延伸——当容器编排足够成熟,企业可以进一步将基础设施管理完全交给平台,只关注业务逻辑。2026年,Serverless已从“实验性技术”变成“生产级标配”。
2.1 Serverless的渗透率:从“边缘”到“主流”
2026年,Serverless迎来了真正的规模化拐点。Datadog估计,超过50%的云原生公司已在生产栈中使用至少一个Serverless组件。全球Serverless市场规模在2025年已突破280亿美元,复合年增长率维持在34%以上。Gartner估计,超过50%的企业在生产环境运行至少一个Serverless组件。
更值得关注的是采用深度的变化。2026年,Serverless架构不再局限于基础函数服务——冷启动延迟已压缩至毫秒级,运行时长限制大幅放宽,可承载复杂生产级业务场景。Serverless架构目前在云应用中占比已升至35%。
CNCF 2026年Serverless使用报告显示,全球已有41%的企业在生产环境中运行Serverless工作负载,而2023年这一比例仅为18%。
2.2 为什么Serverless是“第二层”?
Serverless不是在容器之外另起炉灶——它运行在容器之上,只是把容器的管理权从运维团队手中“抽象”走了。
阿里云ACK Serverless让用户无需管理底层节点即可运行Kubernetes应用。腾讯云超级节点提供了极低迁移门槛,“像管理普通Node一样管理Serverless资源”。这种“容器体验、Serverless代价”的模式,正在成为2026年云架构的主流选择。
2.3 Serverless化的核心价值:弹性即成本
传统模式下,运维团队需要为峰值流量预留资源,导致大量闲置成本。Serverless按实际调用量付费,可以将空转成本降至零。
但Serverless不是万能药。 其适用场景有清晰的边界:
-适合:事件驱动型工作负载(API网关、消息处理、定时任务)、波峰波谷明显的业务、开发和测试环境
-不适合:长时间运行的有状态服务、对冷启动延迟极度敏感的超低延迟场景
2.4 实操清单:Serverless化阶段的三个关键动作
1.识别可Serverless化的工作负载:从无状态、事件驱动、波峰波谷明显的业务开始。不要试图一次性把所有工作负载迁到Serverless。
2.建立混合调度策略:常驻节点(成本低)+ Serverless超级节点(弹性高)的混合调度,通过算法寻找“黄金配比”。小鹅通通过这种策略实现了容器成本降低20%以上。
3.重构可观测性:Serverless函数的生命周期更短、粒度更细,传统的节点级监控失效。需要建立函数级别的调用链追踪和性能监控。
第三章 第三层:AI原生——从“服务弹性”到“智能编排”
核心观点: AI原生不是“在云原生架构上跑AI应用”,而是让架构原生地为“模型+数据+异构算力”而设计——算力从同构CPU变成异构GPU/NPU池,应用从被动响应变成自主智能体,调度对象从进程扩展到Token。
3.1 为什么云原生架构“不够用”了?
在Cloud Native中,调度器只需根据CPU利用率决定要不要扩副本。但在AI Native中,调度器要回答一连串新问题:当前请求需要多大的模型?目标卡的显存是否够用?能否与别的请求合并批处理以提升吞吐?
这种决策维度的急剧膨胀,正是架构必须“原生重构”而非“打补丁”的根本原因。
AI原生架构要求在三个维度上重新假设:
-算力:不再是廉价的同构CPU,而是昂贵且稀缺的GPU/NPU异构池
-应用:不再是被动响应请求的服务,而是能自主规划、调用工具的智能体
-交付物:不再是单纯代码,而是“模型权重+提示词+检索知识”的组合
3.2 2026年AI原生的三个核心战场
战场一:异构算力调度——从“整卡分配”到“精细切分”
这是2026年最迫切的痛点。企业GPU利用率普遍偏低——Cast AI 2026年报告显示,生产Kubernetes集群中GPU平均利用率仅为5%。神州数码指出,企业算力利用率普遍低于20%。
破局工具正在涌现。神州数码HISO异构智能算力调度平台通过在物理卡之上构建虚拟资源池,实现整卡、分片、分时等多策略切分——白天跑推理业务,夜间自动切换做模型训练,实测能将GPU整体利用率提升5倍以上。
华为云CCE Volcano Next通智融合调度引擎打通通用计算与智能计算壁垒,资源利用率提升30%以上,凭借FlexNPU技术实现1%的NPU最小切分,推理实例启动从分钟级缩短至秒级。息壤平台同样实现了单卡切分为多个虚拟算力单元,资源粒度从“整卡”变成“比例”。
CNCF发布的招商银行AI调度平台案例显示,通过异构加速器共享与隔离调度,企业可节省最高80%的硬件采购成本,GPU综合利用率提升5至10倍。
战场二:Agentic Infra——从“云原生”到“智能体原生”
2026年5月,阿里云宣布完成“芯片-云-模型-推理”全栈Agent化升级。6月,华为云正式提出Agentic Infra新范式——“高效Token工厂+通智一体化调度+持续学习+安全自治”。腾讯云将底层架构重构为涵盖“基础设施、模型层、工程层、应用层”的全栈AI原生云平台。
这些头部厂商的动作释放了同一个信号:云服务正在从“服务于人类”转向“服务于智能体” ——每一项云服务都被封装为智能体可直接调用的标准化能力模块。
战场三:Serverless推理——从“按实例付费”到“按Token付费”
AI推理的负载特征是波峰波谷明显、并发请求快速增长。Serverless推理成为最优解——对波峰明显的场景用按需实例,闲时缩容到零。
阿里云ACK已支持通过Knative Serverless架构部署大语言模型推理服务,根据请求并发数实现GPU资源的弹性伸缩。华为云AICS灵衢智算集群将Tokens生成时延压缩至10毫秒以内,千卡每秒吞吐可达500万Tokens。
3.3 实操清单:AI原生阶段的四个关键动作
1.建立异构算力统一调度层:不要为每种芯片单独建池。用vGPU/vNPU技术将不同厂商、不同架构的GPU/NPU资源抽象为统一、可分配、可编排的算力单元。
2.推理与训练资源隔离:生产推理走独立资源池,防止训练任务拖垮线上延迟。
3.建立模型服务化(MaaS)层:用统一推理网关暴露模型,屏蔽底层差异,支持版本路由与灰度。
4.重构可观测性:从Token吞吐、首字延迟(TTFT)到显存占用,建立模型专属指标。
结论:三层递进的路线图与时间表
从云原生到AI原生,不是“推翻重来”,而是三层递进、逐层叠加:
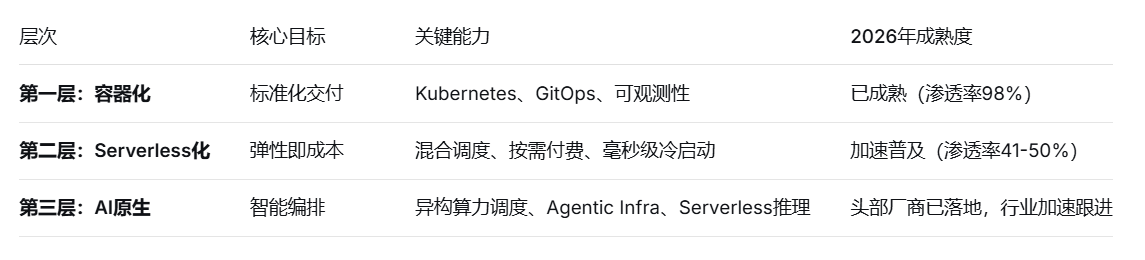
给运维工程师的建议:三层能力缺一不可。 如果只懂Kubernetes不懂Serverless,会被AI时代的弹性需求甩开;如果只懂Serverless不懂异构算力调度,会在AI推理场景中束手无策。建议按“容器→Serverless→异构算力”的顺序系统性构建技能栈——CKA/CKAD认证、Serverless架构设计能力、GPU调度知识,将成为衡量运维工程师竞争力的重要标尺。
给技术管理者的建议:不要等“AI原生”完全成熟再动手。 2026年的现实是:头部云厂商已完成全栈Agent化升级,标准化的AI原生基础设施组件已经可用。建议按“先容器化打基础、再Serverless化提弹性、最后AI原生化抓红利”的节奏推进——每一步都建立在前一步的基础上,而不是跳步。
给企业IT决策者的建议:把“AI就绪”纳入云架构评估的硬性指标。 一个不能调度异构GPU、不能支持Serverless推理、不能为智能体提供标准化API的云平台,在2026年已经落后了。评估云供应商时,不仅要看“有多少机房、多少服务器”,更要看“异构算力调度能力、模型服务化能力、Token效率”——这些新维度将决定未来三年你的AI应用能跑多快、花多少钱。