引言:当AI从“云端”回到“地面”
2026年6月,IDC首次发布《中国智能体开发平台市场份额,2025》报告。数据显示,2025年中国智能体开发平台私有化市场产品收入规模达到17.5亿元人民币,而公有云市场仅约2.5亿元。市场前五名依次为火山引擎、腾讯云、阿里云、蚂蚁数科及电信AI公司。企业AI部署正由公有云大规模向私有化回流。
这一趋势并非偶然。赛迪顾问《2025中国AI Infra平台市场研究报告》显示,2024年国内AI Infra平台市场规模34.5亿元,2025年增至67.3亿元,同比增长95.1%。增长动力来自企业对私有化部署、异构算力调度、推理服务稳定性的强烈诉求。
国务院2025年印发的《关于深入实施“人工智能+”行动的意见》明确提出,到2027年智能体应用普及率超70%,到2030年超90%。政策窗口与产业浪潮叠加之下,一个根本性的基础设施命题浮出水面:当企业AI布局从公有云通用模型转向私域垂直大模型,传统的算力、网络、安全各自为战的供给模式,还能否支撑起智能体时代的底层需求?
本文要回答的核心问题是:企业如何从“算网分离”走向“安全算网”?
我们将沿着一条五步路径展开——算力选型 → 网络规划 → 安全嵌入 → 多智能体协同 → 持续运营——并结合第一线DYXnet“AI原生超互联架构”和三大运营商“AI WAN”方案,提供一套可复用的实操框架。
第一章 第一步:算力选型——从“有什么用什么”到“按场景配算力”
核心观点: 私域AI的算力选型不是“买最贵的GPU”,而是根据模型规模、并发需求、数据安全等级和预算约束,在“满血版”“蒸馏版”“量化版”之间做出工程化的取舍。
1.1 先定模型,再定算力
算力选型的起点不是GPU选型表,而是业务场景和模型规模。
一个实用的决策框架是“三轴决策树”:
-模型参数量:7B以下的小模型,单卡或单机多卡即可承载;14B到70B的中等规模,通常需要多卡并行
-推理并发量:并发用户数和每秒请求数(RPS)直接决定需要的GPU数量和显存配置
-数据安全等级:金融、政务、医疗等高敏感行业,必须优先考虑私有化部署而非公有云API
1.2 GPU选型的四个硬指标
选型核心考量包括四个维度:
-显存容量:决定能加载多大模型。例如7B参数模型推理需要至少14GB显存(FP16精度)
-算力(TFLOPS) :决定推理速度
-NVLink支持:多卡互联带宽,直接影响多卡并行的通信效率
-功耗:数据中心的电力和散热成本
实操建议:先按场景选“满血版”或“蒸馏/量化版”模型,再按模型规模配置GPU(含昇腾、海光DCU等国产算力)和显存,选定vLLM等推理引擎扛并发,最后用平台把多卡、多模型、多团队管理起来。
1.3 国产算力的新选项
2026年,国产算力芯片已进入企业私有化部署的可选项清单。昇腾、海光DCU等方案在特定场景下已具备替代能力。对于有信创要求或数据主权顾虑的企业,将国产算力纳入选型矩阵已成为一个不可回避的决策维度。
本章小结:算力选型的核心原则是 “场景驱动、按需配置、预留扩展” 。不要一次性采购超出需求的算力,也不要忽视未来6-12个月的业务增长预期。
第二章 第二步:网络规划——从“尽力而为”到“无损智算”
核心观点: 私域AI的网络不再是“能通就行”,而是需要面向AI工作负载的“高吞吐、低时延、零丢包”——网络性能直接决定算力利用率和Token成本。
2.1 传统网络为什么“不够用”
TB级数据传输、大模型训练带来更高带宽与时延压力。传统TCP/IP网络在AI场景下面临三大痛点:
-高时延:TCP协议的数十微秒延迟,在多卡并行训练中累积为显著的算力浪费
-低吞吐:传统网络的拥塞控制机制无法满足AI训练的高吞吐需求
-不可预测:“尽力而为”的网络质量让AI训练任务的完成时间不可预期
2.2 两个可参考的架构范式
范式一:第一线DYXnet“AI原生超互联架构”
第一线以全国数据中心集群为基石,构建了面向AI时代的“AI原生超互联架构”。该架构的核心突破在于:通过全RDMA(RoCE)技术打造端到端的城域超互联高速总线,将网络延迟从TCP的数十微秒降至2-3微秒。
这一架构实现了远超TCP的传输带宽与CPU效率,为多智能体协同提供高速、低延迟、安全的通信基础。其技术特点包括:
-远程RDMA技术覆盖多智算数据中心、公有云与企业园区楼宇
-动态切片技术实现网络的动态切换
-整合多区域算力资源形成统一资源池
范式二:运营商AI WAN方案
目前,三大运营商已全部完成AI WAN(智能IP广域网)顶层战略布局。AI WAN采用RDMA租户级精准流控技术,实现拉远训推算效达到95%以上,充分满足AI大模型训练等数据密集型业务的高吞吐、低时延需求。
广西电信携手华为打造的AI WAN算网一体化方案,为企业提供开箱即用、高安全、高吞吐、高算效的灵活弹性用算服务。三大运营商依托全光骨干网与5G/5G-A网络,核心优势在于大范围基础链路覆盖,适合政企分支机构多点互联、基础算力专线调度场景。
2.3 企业网络规划的实操清单
对于正在规划私域AI网络的企业,建议关注以下要点:
-内部互联:智算集群内部必须通过无阻塞的400G甚至800G网络(配合RDMA技术)互联
-跨域互联:如果算力分布在多个数据中心,需要考虑城域/广域RDMA方案(如第一线的AI原生超互联架构或运营商的AI WAN)
-混合云接入:如果采用“本地小算力+云端大算力”模式,需要专线或SD-WAN保障传输质量
本章小结:私域AI的网络规划,核心是从“尽力而为”走向 “确定性网络” ——时延可预期、带宽可保障、丢包可控制。
第三章 第三步:安全嵌入——从“外挂防火墙”到“内生安全算网”
核心观点: 私域AI的安全不能靠“在算网外面加一层防火墙”,而必须将安全能力深度嵌入算力与网络底层——安全不是附加项,而是算网的基础属性。
3.1 私域AI的安全挑战为何不同?
区别于消费级AI,企业私域AI承载核心私有数据,对安全提出体系化要求。算力网络分离导致安全边界模糊,数据跨机房、跨地域流转,存在泄露、篡改、越权访问风险。
传统安全方案的局限:防火墙、DLP、CASB等产品是“外挂”在算网之上的,无法感知AI流量的上下文,也无法在算网内部实施细粒度的策略控制。
3.2 “安全算网”的两个实践方向
方向一:第一线的“安全内嵌”路线
第一线基于AI原生超互联架构,将安全能力深度嵌入算力、网络底层,以安全接入与隐私计算形成双重安全保障。
具体做法包括:
-动态切片与加密技术:通过安全网关产品集成,城域范围内各类算力主体均可就近实现高速安全接入
-动态私有网络:平台创建动态私有网络,无缝连接算力资源、私域数据及模型,构建契合企业自身需求的私有计算空间
-端到端安全:从技术上保障数据在传输与运算过程中的安全性
第一线的方案已获得信通院与CCSA TC621的认可,其“AI原生超互联架构”荣获“算力网络+先锋计划优秀案例”。
方向二:运营商的“端云协同安全”路线
天津移动基于华为AI WAN方案,在天津东丽融媒体中心与天津空港智算中心之间完成了端云协同推理拉远试点。其核心安全机制是:将大模型“一分为二”——敏感计算留在本地,仅将不可还原的中间特征传输至云端。
这意味着:即便传输链路中数据被恶意截获,攻击者也无法还原原始数据。这是从架构层面彻底化解“数据安全”与“算力租用”矛盾的一条可行路径。
3.3 安全算网建设的三个层次
对于正在规划私域AI的企业,建议按以下层次逐步建设安全算网:
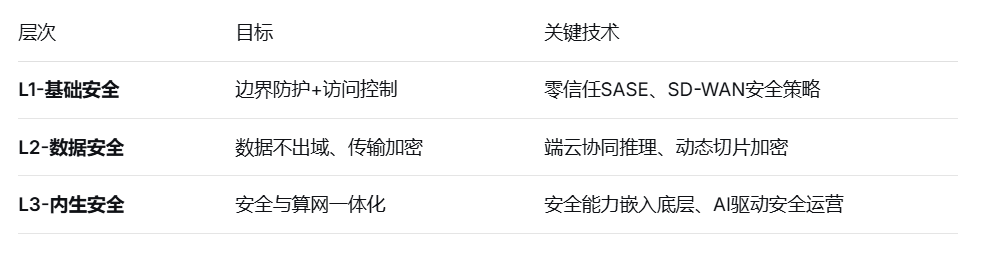
本章小结:安全算网的核心原则是 “内生而非外挂” ——安全不是贴在算网外面的标签,而是从算网诞生的第一天就写进DNA的属性。
第四章 第四步:多智能体协同——从“单点AI”到“Agent集群”
核心观点: 企业私域AI的终极形态不是单个大模型,而是多个智能体协同工作的“Agent集群”——这要求底层算网具备跨区域、低时延、高可靠的协同通信能力。
4.1 为什么需要多智能体协同?
当前,AI正从单点辅助工具向具备自主规划能力的智能体集群演进,多智能体协同已成为突破复杂系统瓶颈的关键路径。单个大模型无法覆盖企业复杂业务流程的全部环节——销售、客服、研发、供应链各需要不同的专业智能体,而这些智能体之间需要高效协同。
第一线网络研发总经理张先国指出,AI原生超互联架构的终极目标是 “赋能企业构建分布式、自组织的AI Agent自治系统” 。
4.2 算网如何支撑多智能体协同?
多智能体协同对底层算网提出了新的要求:
-低时延交互:智能体之间的通信时延必须足够低,否则协同决策将失去实时性
-跨区域连接:不同智能体可能部署在不同数据中心或云平台
-动态调度:算力和网络资源需要根据智能体协同任务动态调度
第一线的AI原生超互联架构正是为此设计——通过全RDMA技术将网络延迟降至2-3微秒,整合多层算力资源,搭建企业专属推理算力池,可根据智能体协同任务动态调度算力与网络资源,平稳承接多智能体并发作业的算力需求。
4.3 实践参考:从“单模型”到“多Agent”的演进路径
对于大多数企业,建议分阶段推进:
阶段一(0-6个月) :部署1-2个核心场景的智能体(如客服Agent、知识库Agent),验证私域AI的可行性。
阶段二(6-12个月) :扩展到3-5个智能体,开始探索智能体之间的协同(如客服Agent调用知识库Agent)。
阶段三(12-24个月) :构建完整的Agent矩阵,覆盖企业核心业务流程,实现智能体之间的自主协同。
本章小结:多智能体协同是私域AI的“终局形态”,而低时延、高可靠、可调度的算网基础设施是这一切的前提。
第五章 第五步:持续运营——从“建好就完”到“算网即服务”
核心观点: 私域AI算网不是“一次性工程”,而是需要持续运营的“基础设施即服务”——运维团队需要从“管服务器”升级为“管算网服务”。
5.1 运维的新挑战
私域AI算网带来了运维范式的根本变化:
-不再是“建好就完” :AI模型持续迭代、算力需求动态变化、网络流量不可预测
-不再是“单点管理” :算力、网络、安全、数据需要统一视图
-不再是“被动响应” :需要主动感知、自动优化、智能运维
5.2 可参考的运营模式
模式一:第一线的“算网即服务”
第一线依托AI原生超互联架构,可以向企业客户一站式交付人工智能算力、RDMA高性能算网、SASE安全的融合服务,灵活形成专属的私域计算空间。这种模式将算网能力封装为服务,企业无需自建全部基础设施。
模式二:运营商的“AI WAN服务化”
中国移动打造算力专网“1+2+3”服务支撑体系,涵盖Token高效供给、生态聚合、差异化运营三大核心竞争力。中国电信“息壤一体化算力网”展示了算力资源统一调度的能力。
5.3 运维团队的技能升级清单
私域AI算网的持续运营要求运维团队具备以下新能力:
-算力调度:理解异构算力调度、算力资源池化
-网络调优:掌握RDMA、无损网络、确定性网络技术
-安全运营:从“边界防护”升级为“零信任+数据安全”
-成本管理:从“管带宽”升级为“管Token”
本章小结:私域AI算网的持续运营,本质是 “从交付产品到交付服务”的转型——运维团队的价值不再体现在“服务器不宕机”,而是“算网服务持续满足业务需求”。
结论:私域AI算网,不是选择题,是必答题
总结性观点:
1.企业AI部署正在从公有云向私有化大规模回流。17.5亿元的私有化市场规模(公有云仅2.5亿元)和95.1%的AI Infra平台年增长率表明:这不是小趋势,而是结构性转变。
2.“算网分离”的时代已经结束。私域AI的核心数据、复杂推理、多智能体协同,要求算力、网络、安全必须一体化设计。各自为战的供给模式已无法支撑智能体时代的底层需求。
3.“五步法”是一条可复制的路径。算力选型→网络规划→安全嵌入→多智能体协同→持续运营——每一步都有可参照的行业实践(第一线的AI原生超互联架构、运营商的AI WAN方案、天津移动的端云协同推理等)。
4.对从业者而言,最大的风险不是“选错方案”,而是“什么都不选” 。私域AI的浪潮不会等人——当你的竞争对手已经开始用私域智能体优化业务流程时,观望本身就是一种落后。
行动建议:
-运维工程师:立即评估所在企业的AI算网就绪度——算力够不够?网络能不能跑RDMA?安全能不能做到“数据不出域”?
-技术管理者:在2026年Q4前完成私域AI算网的可行性评估——明确哪些业务场景适合私有化、需要什么样的算网能力
-企业IT决策者:将“私域AI算网”纳入2027年IT预算的独立项。私域AI不是锦上添花的创新项目,而是未来三到五年企业数字化竞争力的基础设施底座